
UniFi Failover springt hin und her? So habe ich das Pendeln abgestellt
Meine Hauptleitung fällt selten ganz aus. Viel öfter wird sie für ein paar Minuten zäh, Pings brauchen dann mehrere Sekunden. Das Auto-SLA von UniFi schaltet in dieser Zeit nicht um. Ein eigenes SLA mit Latenzgrenze schaltet zwar um, springt dann aber zwischen den Leitungen hin und her, und jeder Wechsel wirft Videocalls und Spiele raus. Jetzt entscheidet ein kleiner Python-Dienst auf meinem Raspberry Pi, wann das Gateway auf die 5G-Leitung geht und wann es zurückkommt.
DarkWolfCave.de
ℹ️ Voraussetzungen: Ein UniFi-Gateway mit zwei Internetleitungen im WAN-Modus “Failover Only”, eine Konsole mit UniFi OS und ein Linux-Rechner im selben Netz, der rund um die Uhr läuft. Bei mir sind das ein UniFi Gateway Max, der UniFi OS Server 5.1.42 mit Network 10.6.109 und ein Raspberry Pi 5 mit Debian 13. Der Dienst braucht nur Python 3, zusätzliche Pakete musst du nicht installieren.
Warum das UniFi-Failover bei einer zähen Leitung nicht hilft
An WAN1 meines Gateways hängt ein Kabelanschluss, an WAN2 ein 5G-Router als Backup. Das Gateway läuft im Modus “Failover Only”: Die Hauptleitung trägt den Verkehr, das Backup springt nur ein, wenn sie ausfällt. Mein Gateway Max hatte ich vor einiger Zeit als Ersatz für das alte USG eingebaut.
Bei mir gibt es zwei Arten von Störungen. Fällt die Hauptleitung hart aus, schaltet das Gateway sofort um, davon merke ich kaum etwas. Häufiger wird sie aber schleichend zäh: Über drei bis fünf Minuten steigt die Latenz auf 1 bis 7 Sekunden, Pakete gehen nur vereinzelt verloren. In dieser Zeit lädt keine Webseite, und Videocalls brechen ab.
Das Auto-SLA kennt keine Latenzgrenze
Im Modus “Auto” nutzt das Gateway laut Ubiquiti drei Prüfungen: einen Ping auf ping.ui.com und die Namensauflösung von ui.com über 1.1.1.1 und über 8.8.8.8. Schlagen zwei davon fehl, gilt die Leitung als ausgefallen. Eine Grenze für die Latenz kannst du dort nicht einstellen. Kommen die Antworten an, wenn auch langsam, bleibt das Gateway auf der zähen Leitung hängen. Bei mir waren das mehrere Minuten.
Ein Custom SLA schaltet um, pendelt dann aber
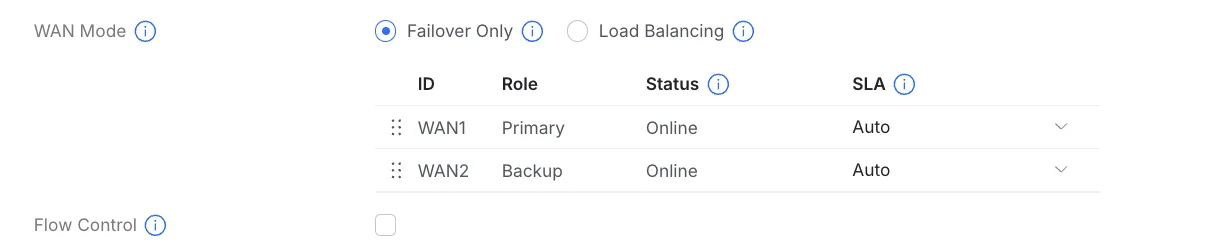
Unter Settings > Internet > WAN SLA > Create New legst du ein eigenes SLA an. Pro Messziel stellst du dort das Ping-Intervall, den Messzeitraum (Time Period) und Grenzwerte für Paketverlust, Latenz und Jitter ein. Danach weist du das SLA in der WAN-Tabelle in der Spalte “SLA” der Hauptleitung zu.
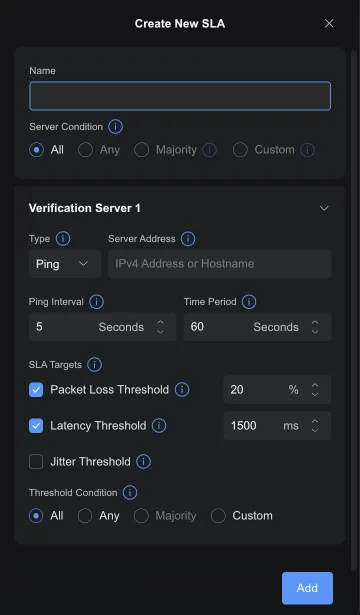
Achte auf die Voreinstellung: 1500 ms Latenz und 20 % Verlust mit der Threshold Condition “All”. Dann müssen beide Grenzen gleichzeitig überschritten sein. Eine zähe Leitung mit hoher Latenz, aber kaum Verlust löst so nie aus. Für ein Failover nach Latenz brauchst du “Any”, dann reicht eine überschrittene Grenze.
Ich hatte Ping auf 1.1.1.1 und 8.8.8.8 eingestellt, alle 5 Sekunden, mit 30 Sekunden Messzeitraum, 500 ms Latenz, 20 % Verlust und “Any”. Damit schaltete das Gateway beim nächsten Einbruch um. Danach ging es aber hin und her: Am 8. November zählte ich zwischen 17:09 und 17:15 Uhr fünf Wechsel auf das Backup und zurück, zwischen 19:09 und 19:17 Uhr vier.
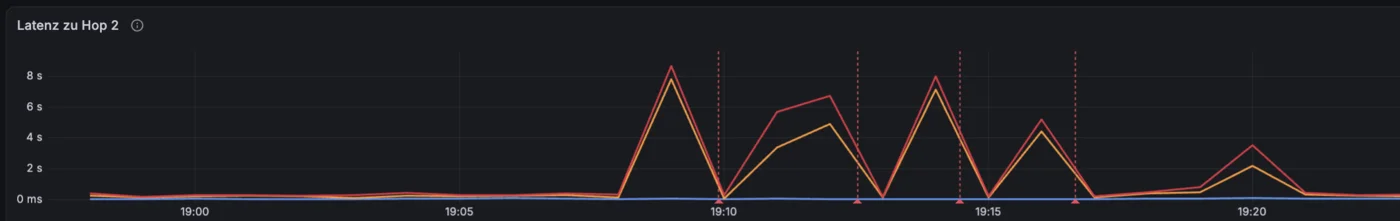
Über das Backup geht mein Netz mit einer anderen öffentlichen IP-Adresse ins Internet, laufende Verbindungen brechen ab. Videocalls, Spiele, SSH-Sitzungen und VPN-Tunnel starten neu, beim Pendeln also alle ein bis zwei Minuten.
Das Gateway misst die Hauptleitung auch während des Failovers weiter. Sobald die Werte wieder unter den Grenzen liegen, schaltet es bei mir zurück, eine Wartezeit gibt es nicht. Bei einer zähen Leitung wechseln sich Spitzen und normale Werte im Minutentakt ab, so entsteht das Pendeln, im Englischen “flapping”. Eine Einstellung, die die Rückkehr verzögert (ein “failback delay”), gibt es in Network 10.6.109 nicht, auch keine Hysterese und kein manuelles Failback. Die Suche nach “failback” im Help Center von Ubiquiti liefert keinen einzigen Treffer, dort steht nur, dass der Verkehr zur Hauptleitung zurückkehrt, sobald sie sich erholt hat. In der Community gibt es dazu Feature-Requests.
Zwei Fallen beim Auswerten
Beim Nachmessen gibt es zwei Fallen. Im System Log der Network-App stehen die Wechsel in der Kategorie “Internet and WAN” als “Temporary Internet Failover”. Der Zeitstempel eines solchen Eintrags ist das Ende eines Zyklus (”… is restored after temporarily failing over”), nicht der Moment des Umschaltens. Und ein Alarm, der die aktive Leitung nur einmal pro Minute abfragt, sieht Zyklen, die kürzer als eine Minute sind, gar nicht. So ging es meinem Grafana-Alarm, der die aktive Leitung über einen eigenen Collector minütlich abfragt. Mit UnPoller als Datenquelle hast du dasselbe Problem, sobald die Abfrage seltener läuft als die Wechsel.
Du wirst hier einen groben Überblick finden.
Allerdings biete ich dir auch noch etwas mehr Support an:
- Du benötigst persönlichen Support
- Du möchtest von Beginn an Unterstützung bei deinem Projekt
- Du möchtest ein hier vorgestelltes Plugin durch mich installieren und einrichten lassen
- Du würdest gerne ein von mir erstelltes Script etwas mehr an deine Bedürfnisse anpassen
Für diese Punkte und noch einiges mehr habe ich einen limitierten VIP-Tarif eingerichtet.
Falls der Tarif gerade nicht verfügbar ist, kontaktiere mich auf Discord!
Was Hysterese beim Failover bedeutet
Mir fehlten also zwei Dinge: ein Umschalten nach Latenz, das nicht pendelt, und eine Wartezeit vor der Rückkehr. Weil UniFi beides nicht zusammen anbietet, habe ich es selbst gebaut. Ein kleiner Python-Dienst auf meinem Raspberry Pi misst beide Leitungen und stellt das Gateway über die API um. Das Prinzip dahinter heißt Hysterese.
Hysterese heißt: Für den Hinweg und den Rückweg gelten unterschiedliche Bedingungen, und dazwischen liegt eine Wartezeit. Ein Thermostat arbeitet so. Die Heizung springt bei 20 Grad an, geht aber erst bei 22 Grad wieder aus. Mit nur einer Grenze würde sie ständig an- und ausgehen.
Für das Failover bedeutet das: Auf das Backup wechselt mein Dienst schnell, sobald die Hauptleitung schlecht ist. Zurück geht es erst, wenn sie eine ganze Weile sauber läuft. Bei mir gelten diese Regeln:
| Auf das Backup | Zurück zur Hauptleitung | |
|---|---|---|
| Zeitraum | 30 Sekunden | 5 Minuten am Stück |
| Bedingung | mehr als die Hälfte der Pings langsamer als 250 ms oder verloren, und zwar bei allen Messzielen | bei allen Messzielen im Schnitt höchstens 150 ms und höchstens 10 % Verlust |
| Zusätzlich | Das Backup muss gesund sein: bei mindestens einem Ziel höchstens 300 ms und 20 % Verlust | Fällt das Backup aus und ist die Hauptleitung nicht schlecht, geht es sofort zurück |
Zwei Sicherungen kommen dazu. Auf das Backup wechselt der Dienst nur, wenn es in der letzten Stunde weniger als sechs Umschaltungen gab, Hin- und Rückweg zusammengezählt. Zurück darf er immer. Und wenn du das Backup selbst zur Hauptleitung gemacht hast, rührt er es nicht an.
Warum ich einen Anteil zähle und keinen Durchschnitt
Im 30-Sekunden-Fenster landen pro Messziel 15 Pings. Jeder Ping wartet höchstens eine Sekunde, langsamere zählen als verloren. Beim Durchschnitt würden schon vier Ausreißer von knapp einer Sekunde reichen, um den Schnitt über 250 ms zu ziehen. Beim Anteil müssen es mindestens acht von 15 sein. Einzelne Spitzen lösen also nichts aus. Bricht die Leitung dagegen komplett ein, ist nach gut 15 Sekunden mehr als die Hälfte der Pings schlecht.
Meine erste Version zählte erst Pings über 500 ms als schlecht und schaute nur auf 16 Sekunden. Inzwischen liegt die Grenze bei 250 ms über 30 Sekunden. Im Normalbetrieb hat meine Hauptleitung 25 bis 90 ms, die Grenze greift also nur bei einer echten Störung.
So arbeitet mein Failover-Dienst
Der Dienst ist ein einzelnes Python-Skript mit knapp 400 Zeilen, das nur die Standardbibliothek nutzt. Er läuft als systemd-Dienst unter einem eigenen Benutzer ohne Root-Rechte.
- Alle 2 Sekunden pingt er je zwei Messziele pro Leitung. Für die Hauptleitung nutze ich 9.9.9.11 und 149.112.112.11, für das Backup 9.9.9.10 und 149.112.112.10. Das sind Adressen des DNS-Dienstes Quad9, laut Quad9 die Varianten mit ECS (.11) und ohne Malware-Filter (.10).
- Zwei Policy-Routes im Gateway binden jedes Paar fest an seine Leitung. Der Kill Switch sorgt dafür, dass die Pings bei einem Ausfall verloren gehen, statt still über die andere Leitung zu laufen. Sonst würde der Dienst eine tote Hauptleitung für gesund halten.
- Aus den Messwerten entscheidet er nach den Regeln oben.
- Zum Umschalten tauscht er über die UniFi-API die Failover-Priorität der beiden WANs. Das ist dasselbe, als würdest du die Leitungen in der WAN-Tabelle per Drag & Drop umsortieren. Das Gateway übernimmt die Änderung nach etwa 13 bis 15 Sekunden.
- Harte Ausfälle erkennt weiterhin das Auto-SLA des Gateways. Der Dienst kümmert sich um die schleichenden.
⚠️ Wichtig: Die Policy-Routes gelten für allen Verkehr vom Pi zu den Messzielen. Nutzt ein Dienst auf dem Pi eine dieser Adressen, etwa Pi-hole oder Unbound als DNS-Server, hängt auch dieser Verkehr fest an einer Leitung und fällt mit ihr aus. Ich habe 9.9.9.9 deshalb gemieden, diese Adresse steht oft als DNS-Server in Konfigurationen. Nimm nur Messziele, die auf dem Pi sonst nichts nutzt.
Ob eine der vier Adressen auf dem Pi schon genutzt wird, prüfst du an zwei Stellen. Konfigurationen direkt auf dem Pi findest du so:
# Auf dem Pi per SSH: Suche nach den vier Messzielen in /etc
# -w trifft nur ganze Adressen, keine Ausgabe = nichts gefunden
sudo grep -rnwE '9\.9\.9\.1[01]|149\.112\.112\.1[01]' /etc 2>/dev/null
Jeder Treffer zeigt Datei und Zeile. Das -w sorgt dafür, dass die zweite Standardadresse von Quad9, 149.112.112.112, nicht mittrifft. Gehört ein Treffer zu einem Dienst, den du weiter so nutzen willst, nimm für den Failover-Dienst andere Messziele. Ein Treffer in /etc/pihole/dns-servers.conf ist harmlos, dort steht nur die Liste der Upstream-Vorlagen, die Pi-hole in der Oberfläche zur Auswahl anbietet.
Laufen Pi-hole oder Unbound wie bei mir in Docker, findet diese Suche ihre Einstellungen nicht. Bei Pi-hole siehst du die Upstreams in der Weboberfläche unter Settings im Reiter DNS im Bereich “Upstream DNS Servers”. Setzt du sie per Umgebungsvariable im Container, etwa FTLCONF_dns_upstreams, stehen sie in deiner Compose-Datei. Für Unbound und die Compose-Datei durchsuchst du das Verzeichnis mit deinen Container-Daten:
# Auf dem Pi per SSH: dieselbe Suche im Verzeichnis deiner Docker-Container
# DOCKER_VERZEICHNIS durch deinen Pfad ersetzen, z. B. den Ordner mit docker-compose.yml und den Mounts
sudo grep -rnwE '9\.9\.9\.1[01]|149\.112\.112\.1[01]' DOCKER_VERZEICHNIS 2>/dev/null
Für das Umschalten nutzt der Dienst die interne API, über die auch die Weboberfläche der Network-App arbeitet. Ubiquiti bietet inzwischen zwar eine offizielle API mit API-Key an, deren Beschreibung nennt aber keine Möglichkeit, die Failover-Priorität zu ändern. Zur internen API habe ich keine offizielle Dokumentation entdeckt. Bei mir funktioniert sie so:
| Schritt | Anfrage |
|---|---|
| Anmelden | POST /api/auth/login mit Benutzername und Passwort |
| CSRF-Token | steckt im Cookie TOKEN (JWT-Feld csrfToken) und geht als Header X-Csrf-Token mit |
| WANs lesen | GET /proxy/network/api/s/default/rest/networkconf, Einträge mit purpose gleich wan, Feld wan_failover_priority |
| Priorität ändern | PUT /proxy/network/api/s/default/rest/networkconf/NETZ_ID mit dem vollständigen Objekt |
Zwei WANs dürfen nicht dieselbe Priorität haben. Sonst antwortet die API mit 400 und api.err.WanFailOverPriorityAlreadyExists. Der Dienst tauscht deshalb über einen Zwischenwert: Hauptleitung auf 3, Backup auf 1, Hauptleitung auf 2. Was sich unter UniFi OS an Login und Pfaden geändert hat, steht in meinem Artikel zum Umzug auf den UniFi OS Server.
Schritt 1: Messziele per Policy-Route an ihre Leitung binden
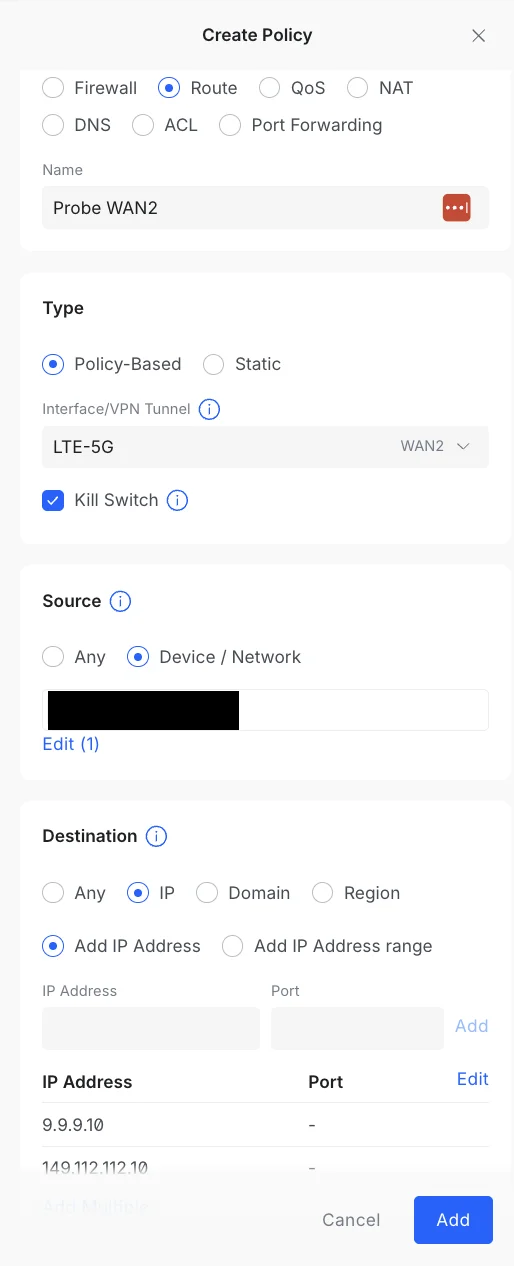
Die Routen legst du in der Network-App unter Settings > Policy Table mit “Create New Policy” an. Als Art wählst du “Route”, als Type “Policy-Based”.
| Feld | Route für WAN1 | Route für WAN2 |
|---|---|---|
| Name | Probe WAN1 | Probe WAN2 |
| Interface/VPN Tunnel | deine Hauptleitung (WAN1) | dein Backup (WAN2) |
| Kill Switch | an | an |
| Source | Device / Network: dein Pi | Device / Network: dein Pi |
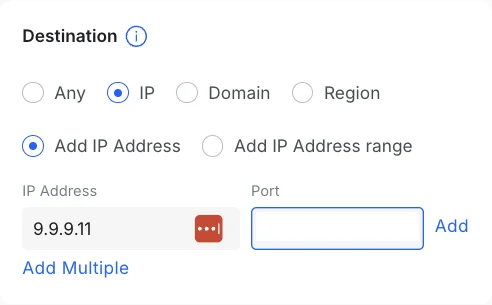
| Destination | IP: 9.9.9.11 und 149.112.112.11 | IP: 9.9.9.10 und 149.112.112.10 |
Jede Adresse trägst du einzeln in das Feld “IP Address” ein und klickst dann auf “Add”. Das Feld daneben heißt “Port” und bleibt leer.
Prüfe danach, ob die Pings über die richtige Leitung gehen. Dafür eignet sich mtr, das die Stationen auf dem Weg zu einem Ziel anzeigt:
# Auf dem Pi per SSH: mtr installieren, falls es noch fehlt
sudo apt install mtr-tiny

# Auf dem Pi per SSH: Weg zu einem Messziel der Hauptleitung
# -n ohne Namensauflösung, -r als Bericht, -c 2 Durchläufe, -m 3 höchstens drei Stationen
sudo mtr -n -r -c 2 -m 3 9.9.9.11

# Auf dem Pi per SSH: dasselbe für ein Messziel des Backups
sudo mtr -n -r -c 2 -m 3 9.9.9.10
In der Spalte HOST stehen die Stationen. Station 1 ist dein UniFi-Gateway. Zeigt sie nur ???, beantwortet das Gateway keine Pings an sich selbst, das ist harmlos. Station 2 ist die erste Station hinter dem Gateway: Bei 9.9.9.11 gehört sie zur Hauptleitung (bei mir der erste Router des Kabelanbieters), bei 9.9.9.10 zum Backup (bei mir die LAN-Adresse des 5G-Routers). Steht bei beiden Zielen in Zeile 2 dieselbe Adresse, greift eine der Routen nicht. Prüfe dann, ob als Source der richtige Pi eingetragen ist.
Schritt 2: Einen lokalen Admin für den Dienst anlegen
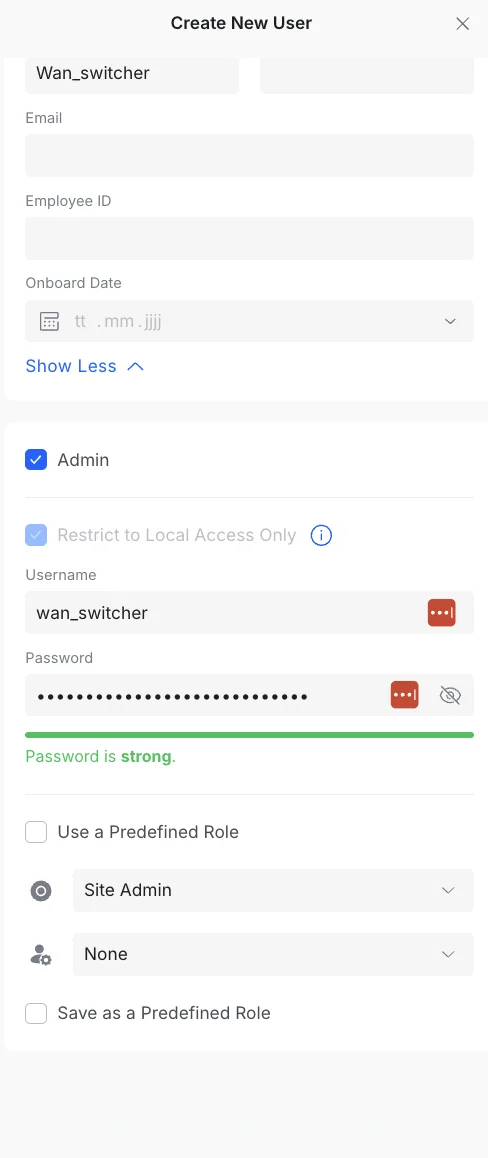
Der Dienst ändert eine Einstellung, deshalb braucht er Schreibrechte in der Network-App. Ein Readonly-User wie für reine Monitoring-Skripte reicht hier nicht. Lege einen eigenen lokalen Admin an, den nur der Dienst nutzt:
- In der Network-App unten links auf das Personen-Symbol klicken, dann auf “Create New” und “Create New User”.
- Den Haken bei “Admin” setzen. “Restrict to Local Access Only” bleibt aktiv.
- Den Benutzernamen
wan_switcherund ein langes Passwort eintragen. - “Use a Predefined Role” abwählen.
- Bei Network “Site Admin” wählen, bei der Benutzerverwaltung “None”.
- Mit “Create” speichern.
Sonderzeichen im Passwort sind kein Problem. In der ersten Version brach der Dienst bei einem % noch mit InterpolationSyntaxError ab, weil Pythons configparser das Prozentzeichen als Platzhalter wertet. Das Skript im Artikel liest die Datei deshalb ohne diese Ersetzung.
🔒 Sicherheit: Dieser Admin darf alle Einstellungen der Network-App ändern. Sein Passwort steht im Klartext in der Konfigurationsdatei, die nur root und der Dienst lesen dürfen. Nutze den Zugang für nichts anderes, und lass “Restrict to Local Access Only” aktiv, damit er nur im lokalen Netz funktioniert.
Schritt 3: Den Dienst auf dem Raspberry Pi einrichten
Alle Befehle in diesem Abschnitt führst du per SSH auf dem Pi aus, der den Dienst später betreibt. Ich habe sie in einem frischen Debian-13-Container durchgespielt, auf meinem Pi läuft der Dienst mit Python 3.13.
Ping ohne Root-Rechte prüfen
Der Dienst pingt als normaler Benutzer. Das erlaubt der Kernel nur, wenn die Gruppe des Benutzers im Bereich ping_group_range liegt:
# Auf dem Pi per SSH: Welche Gruppen dürfen ohne Root pingen?
cat /proc/sys/net/ipv4/ping_group_range
Steht dort 0 und 2147483647, dürfen alle Gruppen pingen, und du musst nichts tun. So war es auf meinem Pi. Steht dort 1 und 0, ist Ping ohne Root gesperrt. Dann legst du eine Einstellung an und lädst sie:
# Auf dem Pi per SSH: nur nötig, wenn oben "1 0" steht
echo 'net.ipv4.ping_group_range = 0 2147483647' | sudo tee /etc/sysctl.d/60-ping-group.conf

# Auf dem Pi per SSH: alle sysctl-Dateien neu laden
sudo sysctl --system
In der Ausgabe von sysctl --system taucht die Zeile * Applying /etc/sysctl.d/60-ping-group.conf ... auf. Ein erneutes cat zeigt dann 0 und 2147483647. Ohne diese Einstellung gehen im Dienst alle Pings verloren, und er schaltet nie um.
Benutzer und Verzeichnisse anlegen
# Auf dem Pi per SSH: Systembenutzer ohne Login und ohne Home-Verzeichnis anlegen
sudo useradd --system --no-create-home --shell /usr/sbin/nologin wan-switcher

# Auf dem Pi per SSH: Kontrolle, der Benutzer hat eine gleichnamige Gruppe
id wan-switcher
Die Ausgabe sieht etwa so aus, die Nummern können bei dir anders sein:
uid=995(wan-switcher) gid=995(wan-switcher) groups=995(wan-switcher)Danach legst du die vier Verzeichnisse mit Besitzer und Rechten in einem Schritt an:
# Auf dem Pi per SSH: Verzeichnisse für Programm, Konfiguration, Zustand und Log anlegen
sudo install -d -m 755 -o root -g root /usr/local/lib/wan-switcher
sudo install -d -m 750 -o root -g wan-switcher /etc/wan-switcher
sudo install -d -m 700 -o wan-switcher -g wan-switcher /var/lib/wan-switcher
sudo install -d -m 755 -o wan-switcher -g wan-switcher /var/log/wan-switcher| Verzeichnis | Inhalt | Rechte |
|---|---|---|
/usr/local/lib/wan-switcher | das Skript | gehört root, der Dienst darf es nur ausführen |
/etc/wan-switcher | die Konfiguration mit dem Passwort | root schreibt, die Gruppe wan-switcher liest, sonst niemand |
/var/lib/wan-switcher | der Zustand in state.json | nur der Dienst |
/var/log/wan-switcher | die Entscheidungen in decisions.csv | der Dienst schreibt, alle dürfen lesen |
Skript anlegen
# Auf dem Pi per SSH: Datei anlegen und das Skript aus dem Kasten unten einfügen
# Speichern mit Strg+O und Enter, beenden mit Strg+X
sudo nano /usr/local/lib/wan-switcher/wan_switcher.py

# Auf dem Pi per SSH: ausführbar machen
sudo chmod 755 /usr/local/lib/wan-switcher/wan_switcher.py

# Auf dem Pi per SSH: Kontrolle, ob die Datei vollständig ist (zeigt die Hilfe an)
python3 /usr/local/lib/wan-switcher/wan_switcher.py --help
Ist die Datei vollständig, erscheint die Hilfe:
usage: wan_switcher.py [-h] [-c CONFIG] {run,status}

WAN-Failover mit Hysterese für ein UniFi-Gateway.
Erscheint gar nichts, fehlt das Ende des Skripts. Bei einem SyntaxError ist beim Einfügen etwas verrutscht. In beiden Fällen öffnest du die Datei noch einmal mit sudo nano und fügst das Skript neu ein.
Das komplette Skript wan_switcher.py
#!/usr/bin/env python3
"""WAN-Failover mit Hysterese für ein UniFi-Gateway.

Pingt feste Messziele pro WAN (per UniFi-Policy-Route mit Kill Switch an
ihre Leitung gebunden) und tauscht die Failover-Priorität der WANs über
die UniFi-Network-API:

  WAN1 primär, alle WAN1-Ziele `fail_window` s lang schlecht, WAN2 gesund
      -> WAN2 wird primär
  WAN2 primär (vom Dienst gesetzt), alle WAN1-Ziele `recover_after` s sauber
      -> WAN1 wieder primär
  WAN2 primär (vom Dienst gesetzt), WAN2 kaputt, WAN1 nicht schlecht
      -> WAN1 sofort wieder primär

Ein von Hand gesetztes WAN2 bleibt unangetastet. Harte Ausfälle erledigt
weiterhin das Gateway selbst.

Entscheidungen gehen nach stdout (journald) und in eine CSV-Datei. Mit
dry_run = true wird am Gateway nichts geändert.

Aufruf: wan_switcher.py run|status [-c CONFIG]
"""

import argparse
import base64
import collections
import configparser
import csv
import datetime
import http.cookiejar
import json
import os
import re
import ssl
import subprocess
import sys
import time
import urllib.error
import urllib.request

RTT_RE = re.compile(r"time[=<]([\d.]+)\s*ms")
CSV_FIELDS = ["ts", "action", "dry_run", "reason", "wan1", "wan2"]


def log(msg):
    print(msg, flush=True)


def now_iso():
    return datetime.datetime.now().astimezone().isoformat(timespec="seconds")


class Api:
    """Minimaler UniFi-OS-Client: Login, GET, PUT mit CSRF-Token."""

    def __init__(self, cfg):
        self.base = cfg.get("unifi", "url").rstrip("/")
        self.site = cfg.get("unifi", "site", fallback="default")
        self.auth = {"username": cfg.get("unifi", "username"), "password": cfg.get("unifi", "password")}
        verify = cfg.getboolean("unifi", "verify_tls", fallback=False)
        ctx = ssl.create_default_context() if verify else ssl._create_unverified_context()
        self.jar = http.cookiejar.CookieJar()
        self.opener = urllib.request.build_opener(urllib.request.HTTPSHandler(context=ctx),
                                                  urllib.request.HTTPCookieProcessor(self.jar))

    def _csrf(self):
        # UniFi OS liefert das CSRF-Token im Cookie TOKEN (JWT-Claim csrfToken).
        token = next((c.value for c in self.jar if c.name == "TOKEN"), None)
        if not token or token.count(".") != 2:
            return None
        payload = token.split(".")[1]
        try:
            return json.loads(base64.urlsafe_b64decode(payload + "=" * (-len(payload) % 4))).get("csrfToken")
        except (ValueError, TypeError):
            return None

    def _request(self, method, path, body=None):
        req = urllib.request.Request(self.base + path, method=method,
                                     data=None if body is None else json.dumps(body).encode(),
                                     headers={"Content-Type": "application/json", "Accept": "application/json"})
        csrf = self._csrf()
        if csrf:
            req.add_header("X-Csrf-Token", csrf)
        with self.opener.open(req, timeout=15) as resp:
            return json.loads(resp.read() or b"{}")

    def login(self):
        self._request("POST", "/api/auth/login", self.auth)

    def call(self, method, path, body=None):
        path = "/proxy/network" + path.replace("{site}", self.site)
        try:
            return self._request(method, path, body)
        except urllib.error.HTTPError as exc:
            if exc.code != 401:
                raise
        self.login()
        return self._request(method, path, body)

    def wans(self):
        """WAN-Netze nach Gruppe (WAN, WAN2)."""
        data = self.call("GET", "/api/s/{site}/rest/networkconf").get("data", [])
        return {n["wan_networkgroup"]: n for n in data if n.get("purpose") == "wan" and n.get("wan_networkgroup")}

    def _set_priority(self, net, prio):
        obj = dict(net)
        obj["wan_failover_priority"] = prio
        res = self.call("PUT", "/api/s/{site}/rest/networkconf/" + net["_id"], obj)
        if res.get("meta", {}).get("rc") != "ok":
            raise RuntimeError("PUT %s -> %s failed: %s" % (net.get("wan_networkgroup"), prio, res.get("meta")))

    def make_primary(self, group):
        """Prioritäten tauschen: `group` bekommt 1, das andere WAN 2 (über 3, doppelte Werte sind verboten)."""
        wans = self.wans()
        other = next(g for g in wans if g != group)
        if wans[group].get("wan_failover_priority") == 1 and wans[other].get("wan_failover_priority") == 2:
            return False
        self._set_priority(wans[other], 3)
        self._set_priority(self.wans()[group], 1)
        self._set_priority(self.wans()[other], 2)
        return True


class Probe:
    """Gleitende Ping-Zeiten pro Ziel, None = verloren."""

    def __init__(self, targets, keep_seconds):
        self.targets = targets
        self.keep = keep_seconds
        self.samples = {t: collections.deque() for t in targets}

    def add(self, target, ts, rtt):
        dq = self.samples[target]
        dq.append((ts, rtt))
        while dq and dq[0][0] < ts - self.keep:
            dq.popleft()

    def stats(self, target, window, now, slow_ms=None):
        vals = [rtt for ts, rtt in self.samples[target] if ts >= now - window]
        if not vals:
            return None
        got = [v for v in vals if v is not None]
        loss = 100.0 * (len(vals) - len(got)) / len(vals)
        avg = sum(got) / len(got) if got else None
        # Anteil der Pings, die verloren oder langsamer als slow_ms sind
        bad = None
        if slow_ms is not None:
            bad = 100.0 * sum(1 for v in vals if v is None or v > slow_ms) / len(vals)
        return {"n": len(vals), "loss": loss, "avg": avg, "bad": bad}

    def summary(self, window, now):
        parts = []
        for t in self.targets:
            s = self.stats(t, window, now)
            if s:
                parts.append("%s loss=%.0f%% avg=%s" % (t, s["loss"], "-" if s["avg"] is None else "%.0fms" % s["avg"]))
        return "; ".join(parts)


def ping_all(targets, timeout):
    """Alle Ziele einmal parallel anpingen, liefert {ziel: rtt_ms oder None}."""
    procs = {t: subprocess.Popen(["ping", "-n", "-c", "1", "-W", str(timeout), t],
                                 stdout=subprocess.PIPE, stderr=subprocess.DEVNULL, text=True)
             for t in targets}
    result = {}
    for t, p in procs.items():
        try:
            out, _ = p.communicate(timeout=timeout + 2)
        except subprocess.TimeoutExpired:
            p.kill()
            out = ""
        m = RTT_RE.search(out or "")
        result[t] = float(m.group(1)) if (p.returncode == 0 and m) else None
    return result


class Switcher:
    def __init__(self, cfg):
        self.cfg = cfg
        g = lambda k, fb=None: cfg.getfloat("policy", k, fallback=fb)
        self.dry_run = cfg.getboolean("policy", "dry_run", fallback=True)
        self.interval = g("interval", 2)
        self.timeout = cfg.getint("probes", "timeout", fallback=1)
        self.fail_window = g("fail_window", 16)
        self.fail_latency = g("fail_latency_ms", 500)
        self.fail_bad = g("fail_bad_pct", 50)
        self.recover_after = g("recover_after", 300)
        self.recover_latency = g("recover_latency_ms", 150)
        self.recover_loss = g("recover_loss_pct", 5)
        self.wan2_latency = g("wan2_max_latency_ms", 300)
        self.wan2_loss = g("wan2_max_loss_pct", 20)
        self.max_per_hour = cfg.getint("policy", "max_switches_per_hour", fallback=6)
        keep = max(self.fail_window, 60) + 5
        self.wan1 = Probe([t.strip() for t in cfg.get("probes", "wan1").split(",") if t.strip()], keep)
        self.wan2 = Probe([t.strip() for t in cfg.get("probes", "wan2").split(",") if t.strip()], keep)
        self.state_file = cfg.get("files", "state")
        self.csv_file = cfg.get("files", "decisions_csv")
        self.api = Api(cfg)
        self.state = self._load_state()
        self.clean_since = None
        self.primary = None
        self.primary_checked = 0.0
        self.started = time.time()
        self.last_note = None
        # Pause nach einem fehlgeschlagenen Umschalten: 60 s, verdoppelt bis 15 min, Reset bei Erfolg.
        # Ohne sie würde eine kaputte API (neues Passwort, neue Network-Version, Konsole aus)
        # bei jeder Messrunde erneut versucht, jedes Mal mit Login und Log-Zeile.
        self.backoff = 0
        self.retry_after = 0.0
        self.last_api_error = None
        # Eigener Speedtest (oder andere geplante Last): unser Verkehr sähe aus wie ein Einbruch,
        # deshalb keine Bewertung, solange die Pause-Datei existiert, und ein fail_window danach.
        self.pause_flag = cfg.get("files", "pause_flag", fallback="").strip()
        self.pause_until = 0.0

    # --- Zustand -----------------------------------------------------------
    def _load_state(self):
        try:
            with open(self.state_file) as fh:
                return json.load(fh)
        except (OSError, ValueError):
            return {"switched_by_us": False, "switches": []}

    def _save_state(self):
        tmp = self.state_file + ".tmp"
        with open(tmp, "w") as fh:
            json.dump(self.state, fh)
        os.replace(tmp, self.state_file)

    def _record(self, action, reason, now):
        row = {"ts": now_iso(), "action": action, "dry_run": self.dry_run, "reason": reason,
               "wan1": self.wan1.summary(self.fail_window, now), "wan2": self.wan2.summary(self.fail_window, now)}
        log("%s%s: %s | WAN1 %s | WAN2 %s" % ("[dry-run] " if self.dry_run else "", action, reason, row["wan1"], row["wan2"]))
        new = not os.path.exists(self.csv_file)
        with open(self.csv_file, "a", newline="") as fh:
            w = csv.DictWriter(fh, fieldnames=CSV_FIELDS)
            if new:
                w.writeheader()
            w.writerow(row)

    # --- Bewertung ----------------------------------------------------------
    def _all(self, probe, window, now, test, slow_ms=None):
        stats = [probe.stats(t, window, now, slow_ms) for t in probe.targets]
        if any(s is None or s["n"] < max(3, int(window / self.interval * 0.6)) for s in stats):
            return False  # noch zu wenig Messwerte
        return all(test(s) for s in stats)

    def wan1_bad(self, now):
        # auf jedem Ziel mehr als fail_bad_pct der Pings verloren oder langsamer als fail_latency:
        # einzelne Ausreißer zählen nicht, ein echter Einbruch greift nach etwa dem halben Fenster
        return self._all(self.wan1, self.fail_window, now, lambda s: s["bad"] > self.fail_bad, self.fail_latency)

    def wan1_clean(self, now):
        return self._all(self.wan1, self.fail_window, now,
                         lambda s: s["loss"] <= self.recover_loss and s["avg"] is not None and s["avg"] <= self.recover_latency)

    def wan2_healthy(self, now):
        stats = [self.wan2.stats(t, self.fail_window, now) for t in self.wan2.targets]
        return any(s and s["loss"] <= self.wan2_loss and s["avg"] is not None and s["avg"] <= self.wan2_latency
                   for s in stats)

    def wan2_broken(self, now):
        return self._all(self.wan2, self.fail_window, now, lambda s: s["loss"] >= 80)

    def _rate_ok(self, now):
        recent = [t for t in self.state.get("switches", []) if t > now - 3600]
        self.state["switches"] = recent
        return len(recent) < self.max_per_hour

    def _refresh_primary(self, now, force=False):
        if not force and now - self.primary_checked < 30:
            return
        # Versuch auch bei einem Fehler merken: sonst würde eine kaputte API (mit Login)
        # in jeder Messrunde gelesen statt alle 30 s.
        self.primary_checked = now
        try:
            wans = self.api.wans()
            self.primary = "WAN2" if wans.get("WAN2", {}).get("wan_failover_priority") == 1 else "WAN"
            if self.last_api_error:
                log("API reachable again")
                self.last_api_error = None
        except Exception as exc:  # weiter messen, auch wenn die API nicht erreichbar ist
            if str(exc) != self.last_api_error:  # jeden Fehler nur einmal protokollieren
                log("API error while reading priorities: %s" % exc)
                self.last_api_error = str(exc)

    def _switch(self, group, reason, now):
        if not self.dry_run:
            if now < self.retry_after:
                return  # Pause nach einem Fehlversuch läuft noch
            try:
                self.api.make_primary(group)
            except Exception as exc:
                self.backoff = min(max(60, self.backoff * 2), 900)
                self.retry_after = now + self.backoff
                self._record("switch-failed", "%s (%s), next try in %ds" % (reason, exc, self.backoff), now)
                self._refresh_primary(now, force=True)
                return
            self.backoff = 0
            self.retry_after = 0.0
        self.state["switches"] = self.state.get("switches", []) + [now]
        self.state["switched_by_us"] = group == "WAN2"
        if not self.dry_run:  # ein simulierter Wechsel darf kein veraltetes "switched_by_us" hinterlassen
            self._save_state()
        self._record("to-" + group, reason, now)
        self.primary = group
        self.primary_checked = now
        self.clean_since = None

    def _paused(self, now):
        if self.pause_flag:
            try:
                if now - os.stat(self.pause_flag).st_mtime < 300:  # älter = Rest eines abgebrochenen Tests
                    self.pause_until = now + self.fail_window
            except OSError:
                pass
        return now < self.pause_until

    def _note(self, text):
        if text != self.last_note:
            log(text)
            self.last_note = text

    def step(self):
        now = time.time()
        targets = self.wan1.targets + self.wan2.targets
        res = ping_all(targets, self.timeout)
        for t in self.wan1.targets:
            self.wan1.add(t, now, res[t])
        for t in self.wan2.targets:
            self.wan2.add(t, now, res[t])
        if now - self.started < self.fail_window:
            return
        if self._paused(now):
            self.clean_since = None
            self._note("own speed test running: not evaluating")
            return
        if not self.dry_run:
            self._refresh_primary(now)
        elif self.primary is None:
            self._refresh_primary(now, force=True)

        if self.wan1_clean(now):
            self.clean_since = self.clean_since or now
        else:
            self.clean_since = None

        if self.primary == "WAN":
            if self.wan1_bad(now):
                if not self.wan2_healthy(now):
                    self._note("WAN1 bad, but WAN2 not healthy either: staying on WAN1")
                elif not self._rate_ok(now):
                    self._note("WAN1 bad, but switch limit (%d/h) reached: staying on WAN1" % self.max_per_hour)
                else:
                    self._switch("WAN2", "WAN1 bad (>%d%% slow/lost over %ds)" % (self.fail_bad, self.fail_window), now)
            else:
                self.last_note = None
        elif self.primary == "WAN2":
            if not self.state.get("switched_by_us"):
                self._note("WAN2 is primary but was not set by wan_switcher: leaving it alone")
                return
            if self.wan2_broken(now) and not self.wan1_bad(now):
                self._switch("WAN", "WAN2 broken, WAN1 usable", now)
            elif self.clean_since and now - self.clean_since >= self.recover_after:
                self._switch("WAN", "WAN1 clean for %ds" % self.recover_after, now)

    def run(self):
        log("wan_switcher started (dry_run=%s, WAN1 probes %s, WAN2 probes %s)"
            % (self.dry_run, ",".join(self.wan1.targets), ",".join(self.wan2.targets)))
        while True:
            t0 = time.time()
            try:
                self.step()
            except Exception as exc:
                log("step error: %s" % exc)
            time.sleep(max(0.0, self.interval - (time.time() - t0)))


def main():
    ap = argparse.ArgumentParser(description=__doc__.split("\n")[0])
    ap.add_argument("mode", choices=["run", "status"])
    ap.add_argument("-c", "--config", default="/etc/wan-switcher/wan-switcher.ini")
    args = ap.parse_args()
    cfg = configparser.ConfigParser(interpolation=None)  # ein "%" im Passwort darf die Datei nicht kaputt machen
    if not cfg.read(args.config):
        sys.exit("cannot read %s" % args.config)
    sw = Switcher(cfg)
    if args.mode == "status":
        wans = sw.api.wans()
        print(json.dumps({g: w.get("wan_failover_priority") for g, w in wans.items()}))
        print(json.dumps(sw.state))
        return
    sw.run()


if __name__ == "__main__":
    main()
Konfiguration anlegen
# Auf dem Pi per SSH: Konfiguration anlegen, den Inhalt aus dem Kasten einfügen und deine Werte eintragen
sudo nano /etc/wan-switcher/wan-switcher.ini

# Auf dem Pi per SSH: nur root und die Gruppe wan-switcher dürfen sie lesen
sudo chown root:wan-switcher /etc/wan-switcher/wan-switcher.ini
sudo chmod 640 /etc/wan-switcher/wan-switcher.ini
# /etc/wan-switcher/wan-switcher.ini
# Besitzer root, Gruppe wan-switcher, Rechte 640 (enthält das UniFi-Passwort)
[unifi]
# Adresse deiner UniFi-Konsole, ein Port gehört direkt dahinter.
# Beispiele: UniFi OS Server auf demselben Pi: https://127.0.0.1:11443
# Konsole mit eigener IP: https://192.168.1.1
url = https://192.168.1.1
site = default
# Lokaler Admin mit Network-Rolle "Site Admin", nur lokaler Zugriff
username = wan_switcher
password = DEIN_PASSWORT
# false bei selbst signiertem Zertifikat der Konsole
verify_tls = false
[probes]
# Messziele, per Policy-Route mit Kill Switch an ihre Leitung gebunden.
# Nur Adressen nehmen, die in deinem Netz sonst nichts nutzt (z. B. kein DNS-Server).
wan1 = 9.9.9.11,149.112.112.11
wan2 = 9.9.9.10,149.112.112.10
# Sekunden pro Ping
timeout = 1
[policy]
# true = nur protokollieren, am Gateway nichts ändern
dry_run = true
# Sekunden zwischen zwei Messrunden
interval = 2
# Auf WAN2 wechseln, wenn auf ALLEN WAN1-Zielen mehr als fail_bad_pct Prozent
# der Pings in fail_window Sekunden langsamer als fail_latency_ms oder verloren sind ...
fail_window = 30
fail_latency_ms = 250
fail_bad_pct = 50
# ... und WAN2 auf mindestens einem Ziel gesund aussieht
wan2_max_latency_ms = 300
wan2_max_loss_pct = 20
# Zurück auf WAN1, wenn ALLE WAN1-Ziele recover_after Sekunden am Stück sauber sind
# (jeweils im Fenster: Schnitt <= recover_latency_ms, Verlust <= recover_loss_pct)
recover_after = 300
recover_latency_ms = 150
recover_loss_pct = 10
# Notbremse gegen eigenes Pendeln
max_switches_per_hour = 6
[files]
state = /var/lib/wan-switcher/state.json
decisions_csv = /var/log/wan-switcher/decisions.csv
# Optional: Pause-Datei deines eigenen Speedtests oder einer geplanten Last. Solange sie
# existiert (jünger als 300 s) und ein fail_window danach wird nicht bewertet. Leer = aus.
pause_flag =Diese Einträge passt du an:
| Eintrag | Was du einträgst |
|---|---|
url | Adresse deiner UniFi-Konsole mit https://. Beim UniFi OS Server gehört der Web-Port dazu, zum Beispiel https://192.168.1.10:11443. Läuft der Server auf demselben Pi wie der Dienst, nimm https://127.0.0.1:11443. |
username, password | der Admin aus Schritt 2 |
wan1, wan2 | die Messziele aus Schritt 1, falls du andere gewählt hast |
dry_run | bleibt vorerst auf true |
Die Rechte 640 mit der Gruppe wan-switcher sind wichtig. Mit 600 und der Gruppe root kann der Dienst seine eigene Konfiguration nicht lesen.
systemd-Dienst einrichten
# Auf dem Pi per SSH: Unit-Datei anlegen und den Inhalt aus dem Kasten einfügen
sudo nano /etc/systemd/system/wan-switcher.service
# /etc/systemd/system/wan-switcher.service
[Unit]
Description=WAN failover with hysteresis for the UniFi gateway
After=network-online.target
Wants=network-online.target
[Service]
Type=simple
User=wan-switcher
Group=wan-switcher
ExecStart=/usr/bin/python3 -I /usr/local/lib/wan-switcher/wan_switcher.py run -c /etc/wan-switcher/wan-switcher.ini
Restart=always
RestartSec=10
# Ping ohne Root: net.ipv4.ping_group_range muss die Gruppe abdecken
NoNewPrivileges=yes
ProtectSystem=strict
ProtectHome=yes
PrivateTmp=yes
ReadWritePaths=/var/lib/wan-switcher /var/log/wan-switcher
[Install]
WantedBy=multi-user.targetUser und Group lassen den Dienst als wan-switcher laufen. NoNewPrivileges, ProtectSystem=strict, ProtectHome und PrivateTmp schränken ihn weiter ein: Er kann keine Rechte dazugewinnen, sieht das System nur lesend und darf nur in die beiden Verzeichnisse unter ReadWritePaths schreiben. Stürzt er ab, startet systemd ihn nach 10 Sekunden neu. -I startet Python isoliert, ohne PYTHON*-Umgebungsvariablen wie PYTHONPATH und ohne Pakete aus Benutzerverzeichnissen.
# Auf dem Pi per SSH: systemd neu einlesen, Dienst beim Booten aktivieren und sofort starten
sudo systemctl daemon-reload
sudo systemctl enable --now wan-switcher

# Auf dem Pi per SSH: Kontrolle, in der Zeile Active muss "active (running)" stehen
systemctl status wan-switcher --no-pager
Log-Rotation einrichten
Die Entscheidungen landen in /var/log/wan-switcher/decisions.csv. Im Normalbetrieb ist das nur eine Zeile pro Umschaltung, die Datei wächst also kaum. Damit sie trotzdem nicht unbegrenzt wächst, rotiert logrotate sie einmal pro Woche und hebt acht komprimierte Wochen auf:
# Auf dem Pi per SSH: Regel für logrotate anlegen und den Inhalt aus dem Kasten einfügen
sudo nano /etc/logrotate.d/wan-switcher
# /etc/logrotate.d/wan-switcher
# Das Skript öffnet decisions.csv für jede Zeile neu und schreibt den Kopf selbst,
# wenn die Datei fehlt. Deshalb weder "create" noch "copytruncate".
/var/log/wan-switcher/*.csv {
su wan-switcher wan-switcher
weekly
rotate 8
compress
delaycompress
missingok
notifempty
}su braucht logrotate, weil das Log-Verzeichnis dem Dienst-Benutzer gehört. Ein create fehlt bewusst: Das Skript öffnet die Datei für jede Zeile neu und schreibt die Kopfzeile selbst, wenn die Datei fehlt. Mit create entstünde nach der Rotation eine leere Datei ohne Kopfzeile.
# Auf dem Pi per SSH: Regel testen, ohne etwas zu ändern (-d = nur anzeigen)
sudo logrotate -d /etc/logrotate.d/wan-switcher
In der Ausgabe steht considering log /var/log/wan-switcher/.... Eine Fehlermeldung oder ein Hinweis auf unsichere Rechte darf nicht auftauchen. Den Rest erledigt der tägliche logrotate-Lauf von Debian.
Du willst deinen Raspberry Pi nicht selbst einrichten? Ich übernehme das für dich —schau dir meine Services an
Schritt 4: Im Testmodus beobachten, dann scharf schalten
Mit dry_run = true misst und entscheidet der Dienst, ändert am Gateway aber nichts. So siehst du, ob er bei dir zu den richtigen Zeitpunkten umschalten würde. Lass ihn so laufen, bis er mindestens einen echten Einbruch mitbekommen hat, und vergleiche seine Entscheidung mit dem, was das Gateway getan hat.
# Auf dem Pi per SSH: Log des Dienstes live mitlesen (Strg+C beendet nur die Anzeige)
sudo journalctl -u wan-switcher -f
Nach dem Start steht dort diese Zeile:
wan_switcher started (dry_run=True, WAN1 probes 9.9.9.11,149.112.112.11, WAN2 probes 9.9.9.10,149.112.112.10)Danach meldet er sich nur, wenn er etwas entscheidet. So sah sein erster Treffer bei mir aus, ohne Datum, Hostname und Prozessnummer:
[dry-run] to-WAN2: WAN1 bad (>50% slow/lost over 16s) | WAN1 9.9.9.11 loss=62% avg=40ms; 149.112.112.11 loss=62% avg=76ms | WAN2 9.9.9.10 loss=0% avg=36ms; 149.112.112.10 loss=0% avg=40msHier hätte der Dienst umgeschaltet: Die Hauptleitung verlor 62 % der Pings, das Backup war sauber. Damals lief noch die erste Version mit 16 Sekunden Fenster. Mein Custom SLA hat erst etwa eine Minute später umgeschaltet und danach wieder gependelt.
Diese Meldungen kann der Dienst schreiben:
| Meldung | Bedeutung |
|---|---|
to-WAN2: WAN1 bad ... | wechselt auf das Backup, dahinter stehen die Messwerte |
to-WAN: WAN1 clean for 300s | zurück zur Hauptleitung nach fünf sauberen Minuten |
to-WAN: WAN2 broken, WAN1 usable | zurück, weil das Backup ausgefallen ist |
WAN1 bad, but WAN2 not healthy either | beide Leitungen schlecht, er bleibt auf der Hauptleitung |
WAN1 bad, but switch limit (6/h) reached | die Notbremse greift, er wechselt in dieser Stunde nicht mehr auf das Backup |
WAN2 is primary but was not set by wan_switcher | du hast das Backup selbst gesetzt, er lässt es in Ruhe |
switch-failed: ..., next try in 60s | das Umschalten über die API ist fehlgeschlagen, dahinter steht die Fehlermeldung. Der nächste Versuch kommt erst nach der genannten Pause: 60 s, dann jeweils doppelt so lang bis höchstens 15 min |
API error while reading priorities | die Konsole ist nicht erreichbar. Er misst weiter, versucht es alle 30 s erneut und meldet jeden Fehler nur einmal |
API reachable again | die Konsole antwortet wieder |
own speed test running: not evaluating | die Pause-Datei existiert, er bewertet gerade nicht (siehe unten) |
Ob Login und API-Zugriff klappen, prüfst du mit dem Befehl status:
# Auf dem Pi per SSH: Prioritäten und Zustand abfragen
# Läuft als wan-switcher, weil nur dieser Benutzer die Konfiguration lesen darf
sudo -u wan-switcher python3 /usr/local/lib/wan-switcher/wan_switcher.py status -c /etc/wan-switcher/wan-switcher.ini
{"WAN": 1, "WAN2": 2}
{"switched_by_us": false, "switches": []}Die erste Zeile zeigt die Priorität jeder Leitung, WAN ist die Hauptleitung (WAN1), und 1 heißt primär. Die zweite Zeile zeigt, ob der Dienst das Backup gesetzt hat, und die Zeitpunkte seiner Umschaltungen als Unix-Zeitstempel. Endet die Ausgabe stattdessen mit HTTPError, stimmen Benutzername oder Passwort nicht. Bei URLError ist die Adresse falsch oder die Konsole nicht erreichbar.
Jede Entscheidung landet außerdem in einer CSV-Datei. Die Datei entsteht mit der ersten Entscheidung:
# Auf dem Pi per SSH: alle bisherigen Entscheidungen als Tabelle anzeigen
column -s, -t /var/log/wan-switcher/decisions.csv
Die Spalten sind Zeitpunkt, Aktion, Testmodus, Grund und die Messwerte beider Leitungen in diesem Moment.
⚠️ Wichtig: Stell vor dem Scharfschalten unter Settings > Internet beide WANs in der Spalte “SLA” auf “Auto”. Ein Custom SLA mit Latenzgrenze auf der Hauptleitung darf nicht parallel laufen, sonst schalten Gateway und Dienst gegeneinander. Das Auto-SLA bleibt für harte Ausfälle zuständig.
Danach schaltest du den Testmodus aus:
# Auf dem Pi per SSH: Testmodus ausschalten (Besitzer und Rechte der Datei bleiben erhalten)
sudo sed -i 's/^dry_run = true/dry_run = false/' /etc/wan-switcher/wan-switcher.ini

# Auf dem Pi per SSH: Dienst neu starten, damit er die Änderung liest
sudo systemctl restart wan-switcher

# Auf dem Pi per SSH: Kontrolle, in der Startzeile muss jetzt dry_run=False stehen
sudo journalctl -u wan-switcher -n 5 --no-pager
Willst du zurück in den Testmodus, tauschst du im sed-Befehl true und false und startest den Dienst neu. Prüfe vorher mit status, ob gerade das Backup primär ist, denn im Testmodus stellt der Dienst nichts zurück. Ist es primär, schiebst du die Hauptleitung unter Settings > Internet per Drag & Drop wieder nach oben.
Mein Ergebnis nach dem ersten Tag
Am 8. November gegen 20 Uhr habe ich den Dienst scharf geschaltet. Um 20:05 Uhr kam der nächste Einbruch: Die Hauptleitung verlor 33 % der Pings bei etwa 234 ms im Schnitt, das Backup lag bei 35 bis 39 ms. Der Dienst schaltete auf das Backup und blieb dort, ohne zu pendeln. Um 20:11 Uhr ging es nach fünf sauberen Minuten zurück. Um 20:14 Uhr fiel die Hauptleitung erneut aus, das Kabelmodem blinkte, und der Dienst wechselte wieder auf das Backup.
Bei einem harten Ausfall schaltet auch das Gateway selbst um, der Dienst setzt zusätzlich die Priorität. Deshalb wartet der Dienst auch hier die fünf Minuten ab, statt beim ersten Lebenszeichen der Hauptleitung zurückzuspringen.
Nach diesem Ausfall blieb der Dienst allerdings auf dem Backup, obwohl die Hauptleitung wieder sauber lief. Schuld war meine erste Regel für den Rückweg.
Zurück schaltet der Dienst nur, wenn die Hauptleitung fünf Minuten am Stück sauber ist. Ob sie sauber ist, prüft er alle 2 Sekunden anhand der letzten 30 Sekunden, also anhand von 15 Pings pro Messziel. Anfangs durften davon höchstens 5 % verloren gehen. Ein einziger verlorener Ping von 15 sind aber schon 6,7 %. Damit galt die Leitung als nicht sauber, und die fünf Minuten begannen von vorn.
Ganz ohne Verluste läuft auch eine gesunde Leitung nicht. Meine Hauptleitung verliert laut meinen Messungen seit Oktober je nach Tag 0,01 bis 0,4 % der Pings. In fünf Minuten schickt der Dienst rund 300 Pings über die Hauptleitung, da geht an schlechteren Tagen oft einer verloren. Fünf Minuten ganz ohne Verlust kamen deshalb nur selten zustande.
Jetzt liegt die Grenze bei 10 %. Ein verlorener Ping pro 30 Sekunden ist damit erlaubt, erst ab zwei beginnen die fünf Minuten neu. Wenn du die Schwellen änderst, rechne kurz nach, wie viel Prozent ein einzelner Ping in deinem Fenster ausmacht.
Die ersten 21 Stunden mit der neuen Regel
Seit der Änderung am 8. November um 21:10 Uhr hat der Dienst in rund 21 Stunden fünfmal auf das Backup gewechselt, drei davon löste mein eigener Speedtest aus (dazu gleich mehr). Jedes Mal schaltete er genau einmal hin und einmal zurück, ohne Pendeln und ohne Fehler beim Umschalten. Auf dem Backup lief mein Netz jeweils 5,5 bis 9 Minuten, zusammen 34 Minuten. Das Gateway meldet seitdem pro Einbruch einen Failover und eine Rückkehr, die kurzen Zyklen aus dem System Log sind verschwunden.
Mein eigener Speedtest löste das Failover aus
Bei der Auswertung fiel mir etwas auf: Gut die Hälfte aller Umschaltungen seit dem Start lag fünf Minuten nach der vollen Stunde. Zu dieser Zeit läuft bei mir stündlich ein automatischer Speedtest, der den Upload voll auslastet. Ist der Upload ohnehin knapp, staut sich der Verkehr vor der Leitung, die Pings des Dienstes werden langsam, und er schaltet um. Unter Volllast misst der Dienst also auch den Stau im eigenen Upload (Bufferbloat), nicht nur die Leitung. Startet der Speedtest, während das Backup aktiv ist, misst er außerdem das Backup und verbraucht mobiles Datenvolumen.
Mein Dienst nimmt solche Zeiten deshalb inzwischen aus der Bewertung. Dafür gibt es in der Konfiguration die Option pause_flag. Solange die dort eingetragene Datei existiert, bewertet der Dienst nicht, und danach noch ein Messfenster lang (30 Sekunden). Im Journal steht dann einmal own speed test running: not evaluating. Außerdem habe ich meinen Speedtest so umgestellt, dass er nicht läuft, solange das Backup aktiv ist.
Lässt du selbst regelmäßig Speedtests oder große Uploads wie Datensicherungen laufen, trag in der Konfiguration eine Pause-Datei ein und setz sie in deinem Skript:
# In deinem Speedtest- oder Datensicherungs-Skript auf dem Pi (läuft als root)
# In der Konfiguration des Dienstes steht dazu: pause_flag = /run/wan-switcher-pause
touch /run/wan-switcher-pause
# ... hier deine Last, zum Beispiel der Speedtest ...
rm -f /run/wan-switcher-pause
Die Datei muss unter /run oder einem anderen Systempfad liegen. Unter /tmp oder in einem Home-Verzeichnis sieht der Dienst sie nicht, weil die Unit PrivateTmp und ProtectHome nutzt. Ist die Datei älter als fünf Minuten, ignoriert der Dienst sie, damit ein abgebrochener Test ihn nicht dauerhaft stilllegt. Dauert deine Last länger, erneuere sie zwischendurch mit touch.
Das 5G-Backup: TP-Link Archer NX600 statt LTE-Modem
An WAN2 hängt bei mir ein TP-Link Archer NX600. Das ist ein 5G-Router für drinnen, der im Nachbarzimmer am Fenster steht. Ein 12 Meter langes, dünnes Netzwerkkabel führt unter dem Teppich zum Gateway. Vorher war es ein Netgear LB2120, ein LTE-Modem der Kategorie 4 mit externer MIMO-Antenne.
In meinen Messungen liegt die 5G-Leitung im Schnitt bei 23 bis 27 ms, Spitzen bleiben meist unter 50 ms, auch tagsüber. Das LB2120 kam auf 35 bis 40 ms mit Spitzen bis 100 ms.
So habe ich das NX600 an das Gateway angeschlossen:
- Das Kabel kommt an einen der 1-Gbit-LAN-Ports des NX600. Der 2,5-Gbit-Port arbeitet im Mobilfunkbetrieb als WAN-Eingang und verteilt keine Adressen.
- Die DMZ des NX600 zeigt auf die Adresse, die das Gateway auf WAN2 bekommt. So landet eingehender Verkehr beim Gateway.
- Das WLAN des NX600 ist aus, das Funknetz macht UniFi.
- NAT bleibt an. Ohne NAT würde das NX600 die Pakete des Gateways mit dessen privater Adresse ins Mobilfunknetz schicken, und die Antworten kämen nicht zurück.
Die IPv4-Adresse im Mobilfunk liegt bei mir hinter einem Carrier-Grade-NAT. Portweiterleitungen und eingehende VPN-Verbindungen funktionieren deshalb nicht, solange das Backup aktiv ist.
Meine Einschätzung
Für meine Hauptleitung reichten die Bordmittel von UniFi nicht. Das Auto-SLA schaltet bei einer zähen Leitung nicht um, ein Custom SLA pendelt. Mit knapp 400 Zeilen Python und zwei Policy-Routes habe ich jetzt ein Failover, das früh umschaltet und erst zurückkehrt, wenn die Hauptleitung fünf Minuten am Stück sauber läuft.
Fällt deine Hauptleitung nur hart aus, brauchst du den Dienst nicht, dafür reicht das Auto-SLA. Wenn sie wie bei mir zäh wird, starte mit dem Testmodus aus Schritt 4. Die Schwellen passt du an deine Leitung an. Liegt sie im Normalbetrieb deutlich über 90 ms, setz fail_latency_ms und recover_latency_ms höher. Liegt der Normalwert über recover_latency_ms, kehrt der Dienst nie zur Hauptleitung zurück.
Was der Dienst nicht abdeckt
- Jede Umschaltung trennt weiterhin laufende Verbindungen. Der Dienst sorgt nur dafür, dass es seltener passiert.
- Die interne API kann sich mit einem Update ändern. Schau nach einem Update der Network-App ins Log. Klappt das Umschalten nicht mehr, steht dort
switch-failedmit der Fehlermeldung. - Die Priorität ist eine gespeicherte Einstellung. Fällt der Pi oder die UniFi-Konsole aus, während das Backup aktiv ist, bleibt das Gateway auf dem Backup. Dann schiebst du die Hauptleitung unter Settings > Internet per Drag & Drop zurück nach oben. Bei mir laufen Dienst und UniFi OS Server auf demselben Pi, ein Ausfall des Pi trifft also beide.
- Ohne laufenden Dienst verhält sich das Gateway wie vorher mit dem Auto-SLA.
Da jede Umschaltung eine neue öffentliche IP-Adresse bringt, passt dazu mein Skript, das dich bei einer Änderung der WAN-IP benachrichtigt.
5G-Router, Zubehör und Antennen für ein zweites WAN
Meine Hardware für das 5G-Backup
Produktbilder ausgeblendet. Beim Laden wird deine IP-Adresse an Amazon übermittelt.
| Bild | Produkt | Preis | |
|---|---|---|---|
| Produktdaten werden geladen... | |||

Kommentare